Ближайшие соседи и масштаб признаков
ЧерновикМатериалы дорабатываются и будут дополняться.
Чему научимся
В игре появился новый герой. У него 650 единиц здоровья и 8 единиц магической силы. Можно ли по этим числам предположить, кто он: воин или маг?
В прошлом занятии наша модель давала всем один ответ. Теперь попробуем учитывать признаки: искать знакомых героев, похожих на нового.
После занятия вы сможете:
- Вычислять расстояния и предсказывать класс голосованием соседей.
- Объяснять, почему изменение масштаба признака может изменить прогноз.
- Проверять выбранное правило на новых примерах с известными ответами.
Время и подготовка: ориентир 6–7 часов с практикой. Нужны координаты на плоскости, модуль числа, дроби и основы Python; теорема Пифагора поможет сравнить два расстояния.
Пойдём по шагам: сравним героев вручную, изменим масштаб здоровья, устроим голосование и повторим опыт на Python.
Карточки знакомых героев
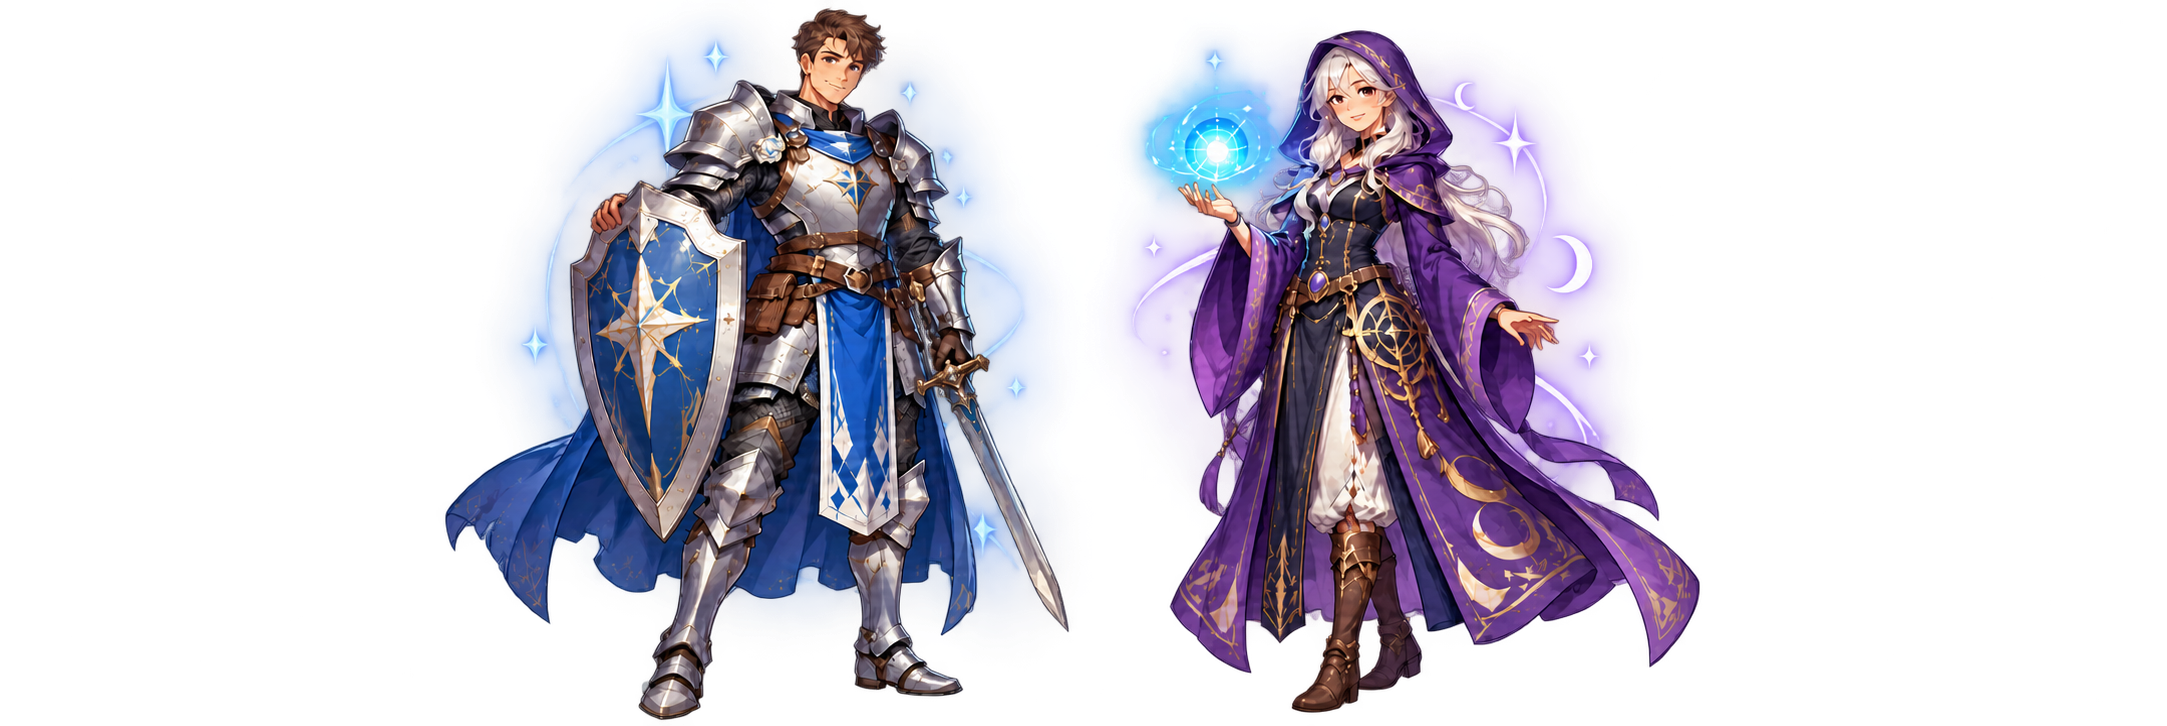
Здоровье и магическая сила известны до прогноза. Класс — ответ, который хотим получить. Это задача классификации.
| Герой | Здоровье | Сила | Класс |
|---|---|---|---|
| А | 800 | 2 | воин |
| Б | 700 | 3 | воин |
| В | 300 | 9 | маг |
| Г | 400 | 8 | маг |
| Новый | 650 | 8 | неизвестен |
Четыре знакомые карточки — обучающая часть. Новый герой — запрос к модели; его класс пока скрыт. Названия А–Г признаками не служат.
Найдём самого похожего знакомого героя и возьмём его класс. Это метод ближайшего соседа: похожим по признакам объектам предсказываем одинаковый ответ.
Что значит «похожий»?
Для одного числа расстояние — модуль разности. Между здоровьем 650 и 700 оно равно
Для двух признаков сначала сложим их отличия. Обозначим здоровье через
Такое расстояние называют манхэттенским. Посчитаем расстояние от нового героя до героя Б. У нового здоровье 650 и сила 8, у Б — здоровье 700 и сила 3:
- Разница здоровья:
. - Разница магической силы:
. - Складываем обе разницы:
Так же считаем расстояния до остальных героев:
| Герой | По здоровью | По силе | Сумма |
|---|---|---|---|
| А | 150 | 6 | 156 |
| Б | 50 | 5 | 55 |
| В | 350 | 1 | 351 |
| Г | 250 | 0 | 250 |
Минимальное расстояние у Б. Значит, один ближайший сосед предсказывает «воин».
Можно измерять и по-другому: евклидово расстояние соответствует отрезку напрямую, как в теореме Пифагора:
Например, для точек

Эти способы измерения могут выбирать разных соседей. Дальше используем манхэттенское расстояние.
Почему здоровье перевесило магию
У нового героя сила совпадает с силой мага Г. Однако по нашему правилу победил воин Б: отличия здоровья измеряются сотнями, а силы — единицами. Численно здоровье вносит гораздо больший вклад.
Представьте, что рост записали сначала в метрах, а затем в сантиметрах. Люди не выросли в сто раз, но числа стали в сто раз больше. Если просто складывать отличия, вклад роста тоже увеличится.
В нашей игре попробуем измерять здоровье в сотнях единиц: 800 станет 8, а 650 — 6,5. Для знакомых и нового героя используем одно преобразование. Расстояние теперь такое:
| Герой | По здоровью | По силе | Сумма |
|---|---|---|---|
| А | 1,5 | 6 | 7,5 |
| Б | 0,5 | 5 | 5,5 |
| В | 3,5 | 1 | 4,5 |
| Г | 2,5 | 0 | 2,5 |
Теперь ближайший — Г, а прогноз — «маг». На схеме те же карточки расположены от ближней к дальней для каждого масштаба.

Мы выполнили масштабирование признака: изменили его числовой масштаб и тем самым его вклад в расстояние.
Удобный способ выбрать масштаб — min–max нормализация. Находим минимальное значение признака
Числитель показывает расстояние от минимума до нашего значения, а знаменатель — расстояние между минимумом и максимумом. Так минимум превращается в 0, максимум — в 1, а значения между ними попадают в отрезок
Для здоровья наших четырёх героев минимум равен 300, максимум — 800. Весь диапазон составляет
От минимума до нового героя — 70 % всего диапазона. На схеме меняются подписи шкалы, а порядок героев сохраняется.

Каждый признак нормализуют по своим границам. Для силы минимум равен 2, максимум — 9, поэтому сила нового героя 8 станет
Пусть соседи проголосуют
Один сосед может оказаться необычным или иметь ошибочную метку. Дадим слово нескольким: найдём k ближайших соседей, и пусть каждый проголосует за свой класс. Выберем класс с наибольшим числом голосов. Метод называют KNN, от английского k-nearest neighbors.
После изменения масштаба при
Малое
При
Сначала повторим голосование без библиотеки на четырёх карточках после деления здоровья на 100. Здесь sorted ставит пары «расстояние, класс» от ближайшего героя к дальнему:
known = [(8, 2, "воин"), (7, 3, "воин"),
         (3, 9, "маг"), (4, 8, "маг")]
new_health, new_magic = 6.5, 8
neighbors = []
for health, magic, label in known:
    distance = abs(health - new_health) + abs(magic - new_magic)
    neighbors.append((distance, label))
nearest_three = sorted(neighbors)[:3]
votes = [label for _, label in nearest_three]
print(nearest_three, max(set(votes), key=votes.count))
Тройка состоит из двух магов и одного воина, поэтому ответ — «маг». В реальной таблице лучше использовать готовую реализацию, которая учитывает выбранную метрику и умеет обрабатывать много запросов.
Повторим на Python
Используем scikit-learn: MinMaxScaler выполнит нормализацию, а KNeighborsClassifier найдёт соседей и проведёт голосование. Библиотека входит в среду учебника.
Признаки и ответы храним отдельно. В каждой строке X_train стоят здоровье и сила одного героя; на той же позиции в y_train записан его класс. В X_new одна строка — новый герой.
from sklearn.neighbors import KNeighborsClassifier
from sklearn.preprocessing import MinMaxScaler

names = ["А", "Б", "В", "Г"]
X_train = [[800, 2], [700, 3], [300, 9], [400, 8]]
y_train = ["воин", "воин", "маг", "маг"]
X_new = [[650, 8]]
Нормализуем оба признака по формуле min–max. Вызов fit_transform находит границы по обучающим данным и преобразует их. Для нового героя вызываем transform: используем уже найденные границы.
scaler = MinMaxScaler()
X_scaled = scaler.fit_transform(X_train)
X_new_scaled = scaler.transform(X_new)

print(X_scaled.round(3))
print(X_new_scaled.round(3))
У нового героя получатся признаки примерно round(3) округляет вывод до трёх знаков; в вычислениях остаются исходные значения.
Создадим модель с тремя соседями. metric="manhattan" задаёт манхэттенское расстояние. Вызов fit сохраняет обучающие примеры и их классы, а predict возвращает прогнозы для новых объектов.
knn = KNeighborsClassifier(n_neighbors=3, metric="manhattan")
knn.fit(X_scaled, y_train)

prediction = knn.predict(X_new_scaled)
print("Класс нового героя:", prediction[0])
Получим «маг». Посмотрим, кто проголосовал: kneighbors возвращает расстояния и индексы соседей. Индекс — номер строки в обучающей таблице, начиная с нуля. Мы передали один новый объект, поэтому берём первую строку результатов.
distances, indices = knn.kneighbors(X_new_scaled)
for distance, index in zip(distances[0], indices[0]):
    print(names[index], y_train[index], round(distance, 3))
Вывод: Г — маг, 0,5; Б — воин, примерно 0,814; В — маг, примерно 0,843. Два голоса за мага. После min–max порядок отличается от деления здоровья на 100: теперь мы изменили масштаб и здоровья, и силы.
Попробуйте сами
- Нормализуйте героя
по границам обучающей таблицы и найдите ближайшего соседа вручную. Затем проверьте через kneighbors: для одного соседа передайтеn_neighbors=1. Для самопроверки: признаки, ближайший — А, расстояние 0,06. - Для исходного запроса сравните
и , меняя n_neighborsпри создании модели. Затем сравните обучение на исходных и нормализованных признаках. Для самопроверки: при обоихисходные признаки дают «воин», min–max — «маг». - Верните
и min–max нормализацию. Проверьте модель на трёх новых карточках ниже. Метрика — доля верных ответов из занятия 1.1.
| Герой | Здоровье | Сила | Ответ для проверки |
|---|---|---|---|
| Д | 770 | 2 | воин |
| Е | 350 | 9 | маг |
| Ж | 450 | 7 | маг |
Это тестовая часть. Преобразуем признаки тем же scaler, затем получим прогнозы. Метод score сравнивает их с известными классами и возвращает долю верных ответов.
X_test = [[770, 2], [350, 9], [450, 7]]
y_test = ["воин", "маг", "маг"]
X_test_scaled = scaler.transform(X_test)

print("Прогнозы:", knn.predict(X_test_scaled))
print("Доля верных ответов:", knn.score(X_test_scaled, y_test))
Для самопроверки: прогнозы «воин», «маг», «маг», доля верных —
Три верных ответа из трёх — результат только этих карточек, а не доказательство, что модель всегда угадывает класс. На таком маленьком наборе один следующий промах резко изменит долю верных ответов.
Что стоит унести с собой
KNN отвечает по похожим обучающим примерам. Что считать похожим, определяют признаки, расстояние и масштаб. Число соседей определяет, кто голосует. А узнать, полезно ли всё правило, можно только по новым известным ответам.
Проверьте себя: кто станет ближайшим без масштабирования и после него? Почему границы нормализации ищем только по обучающим героям? Что можно и нельзя заключить из трёх правильных ответов на тесте? Подсказки и решения — в вопросах ниже.
Самопроверка
Проверено 0 из 10
Подсказка
Какие свойства известны до предсказания?
Решение
A. Оба признака доступны заранее. Правильный класс — искомый ответ, его использование было бы утечкой.
Подсказка
Разницы координат равны 3 и 4. В одном правиле складывают модули, в другом используют корень из суммы квадратов.
Решение
B.
Подсказка
Сравните все четыре суммы, учитывая оба признака.
Решение
C. До Б расстояние 55. Совпадение одной силы у Г не отменяет разницу здоровья 250.
Подсказка
Посчитайте
Решение
D. Получаем
Подсказка
Подставьте
Решение
A.
Подсказка
Голосуют только выбранные три соседа, каждый с одним голосом.
Решение
B. Г и В — маги, Б — воин. А в выбранную тройку не входит.
Подсказка
Во всей обучающей части два воина и два мага.
Решение
C. При
Подсказка
Сколько разных обучающих объектов доступно для голосования?
Решение
D. Допустимо KNeighborsClassifier выдаст ValueError.
Подсказка
Сколько соседей участвует в таком решении?
Решение
A. Голос единственного соседа решающий. Несколько соседей иногда помогают, но гарантии исправления нет.
Подсказка
На каких именно примерах измерен результат?
Решение
B. Мы проверили три конкретные карточки. Это не раскрывает класс другого героя и не обещает успех на любых данных; подбор настроек по тесту испортит независимость проверки.